

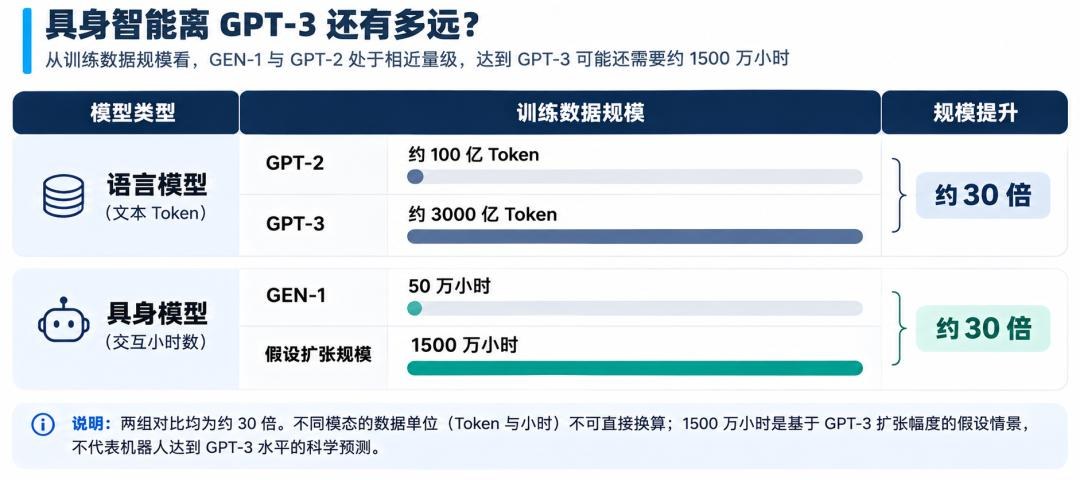
Dealroom 称 2026 年全球具身智能创业公司已获约 110 亿美元风投,超 2025 全年两倍;但 IDC 统计 2025 年全球人形机器人出货超 1.8 万台,逾 85% 仍用于文娱、教研、采数与导览,真正进工厂物流承担生产的仍是少数。行业叙事正从「谁的本体更炫」转向 数据:需要多少真实世界经验、从哪来、哪类最有价值、谁能变现。粗略对照大模型从 GPT-2 到 GPT-3 约 30 倍数据扩张,若具身也走类似幅度,从 Generalist GEN-1 的约 50 万小时预训练出发,下一阶段或需约 1500 万小时——规模之外,还要提高有效信息密度,并补上视觉难覆盖的接触与力觉。
Scaling:27 万→50 万小时,仍像 GPT-2 量级
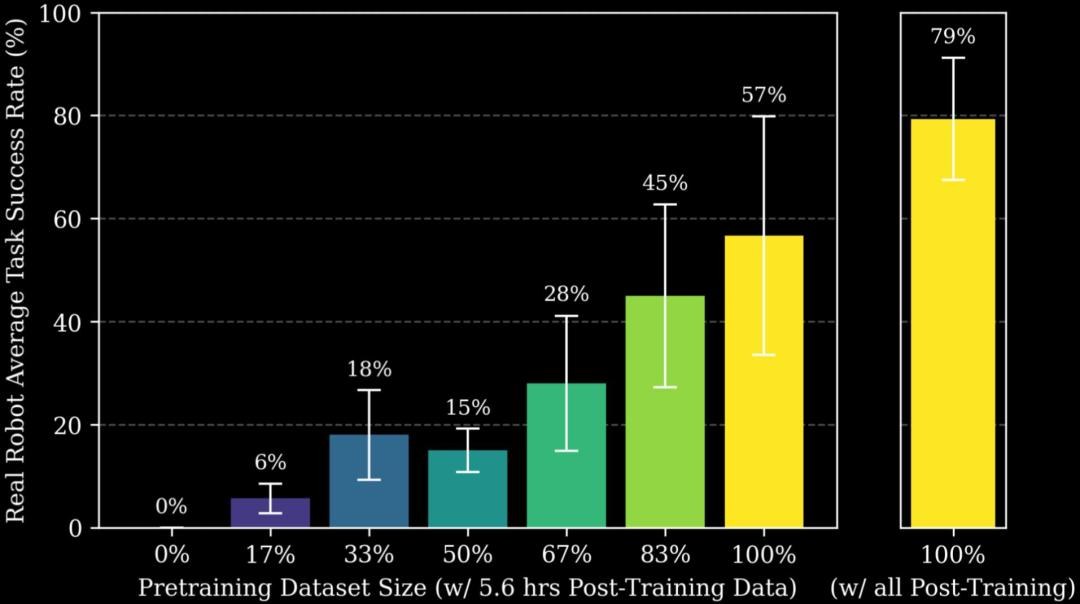
2025 年 11 月 Generalist 发布 GEN-0,用超 27 万小时真实物理交互预训练,相对当时代表性开源集 Open X-Embodiment 约 6000 小时高出近五十倍,并观察到数据与算力扩大后下游任务改善。五个月后 GEN-1 推到 50 万小时,任务成功率据称从 64% 到 99%、速度约快 3 倍,并现跨场景泛化与自主纠错苗头;2026 年 8 月 GEN-1.5 进一步展示 Physical Prompting:给 3–12 秒示范即可不更新参数尝试新任务。以「人一生观察约 35 万小时」类比,50 万小时约 1.43 倍——量级近 GPT-2,不等于能力已对齐 GPT-3。拧瓶盖类任务里,真正决定成败的发力、打滑与重试往往只占轨迹一小段,故瓶颈是「便宜扩规模」与「提高有效密度」两道题。具身评测与统一接口亦在推进,可对照本站 uni-robot-agent / OpenRUA 与 Astra 冲击 RoboDojo。
三条采数路径:真机、人类操作、Ego 视频
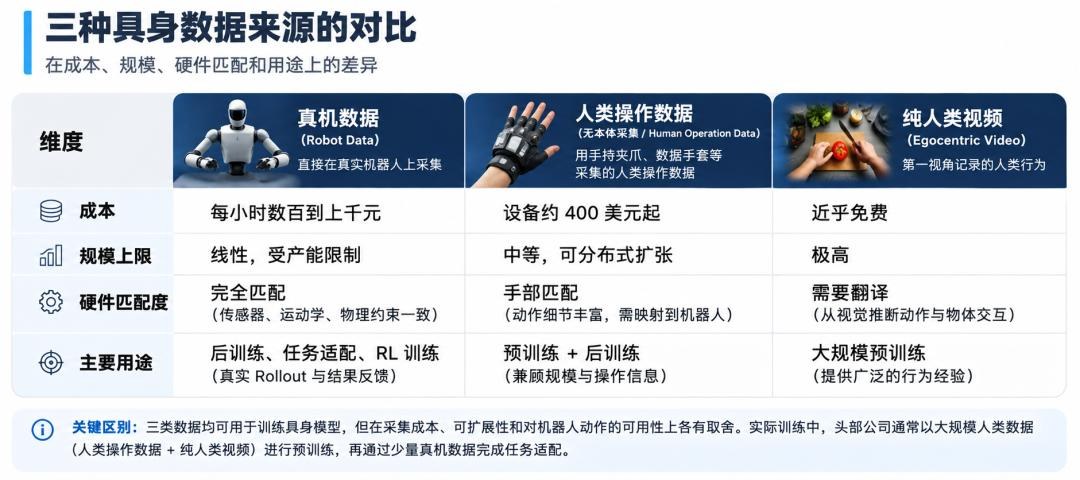
– 真机遥操作:视觉+关节+轨迹与目标硬件匹配,Tesla、Figure、智元等用过,但机器/人/场地贵,难撑千万小时。 – 无本体人类操作:手持夹爪/数据手套等(如斯坦福 UMI);Sunday Robotics 称近 1000 万条轨迹训 Memo/ACT-1;Generalist 的 50 万小时亦主靠可穿戴采人类操作。 – 纯人类第一视角视频:规模最大——NVIDIA EgoScale 超 2 万小时,Dyna-2 预训练超 100 万小时;难点是缺可直接执行的动作标签,需推断再映射,并辅以少量真机适配。
头部趋势多为「大规模人类数据预训练 + 少量真机适配」,配方尚未统一;竞争在于谁能更低成本把异构来源转成可学动作与经验。
新缺口:接触力觉;三类赚钱玩家
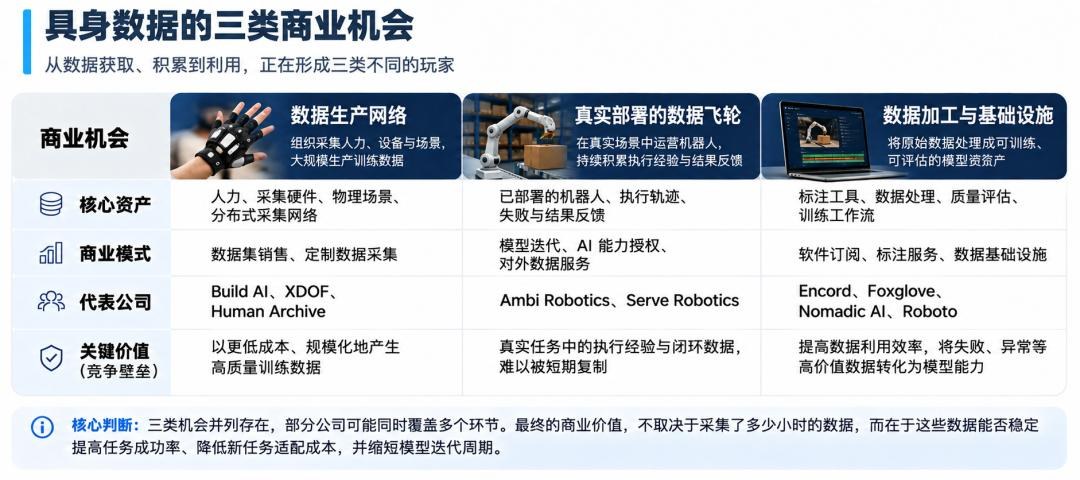
松下联合 Berkeley、NVIDIA 等的 T-Rex 将指尖触觉引入动作模型:12 项精细任务平均成功率约 65%,去掉触觉降至约 42%。YC F26 中 Axonnic、Hemlock、Preload 等从肌电袖套/手环与视触多模态切入,补发力与接触。商业侧大致三类:① 数据生产网络(Build AI 工厂场景、XDOF ABC-130K 约 13 万轨迹/3500 小时、Human Archive、京东计划动员最多 60 万人两年攒 1000 万小时等);② 部署飞轮(Ambi 超 1.5 亿件包裹、25 万小时生产数据;Serve 基于 2000+ 台车推 Physical AI Services);③ 加工与评测 Infra(Encord、Foxglove、Nomadic AI、Roboto 等把原始日志变成可训练、可找失败样本的资产)。最终检验不是采集了多少小时,而是能否稳定提高成功率、降低新任务适配成本——并让机器人独立扛完一个班次。
常见问题
Q:为什么说有约「30倍」数据缺口? A:以大模型从 GPT-2 到 GPT-3 约 30 倍数据扩张作粗类比,若具身从约 50 万小时再扩同量级,或需约 1500 万小时量级。
Q:视频数据够不够? A:规模易扩,但缺力觉与精确动作监督;精细操作上触觉等接触信息已显示可显著抬成功率。
Q:数据生意比拼什么? A:不只卖小时数,还要验证对任务成功率与迭代周期的贡献,否则易陷入按小时报价的产能战。
相关文章