

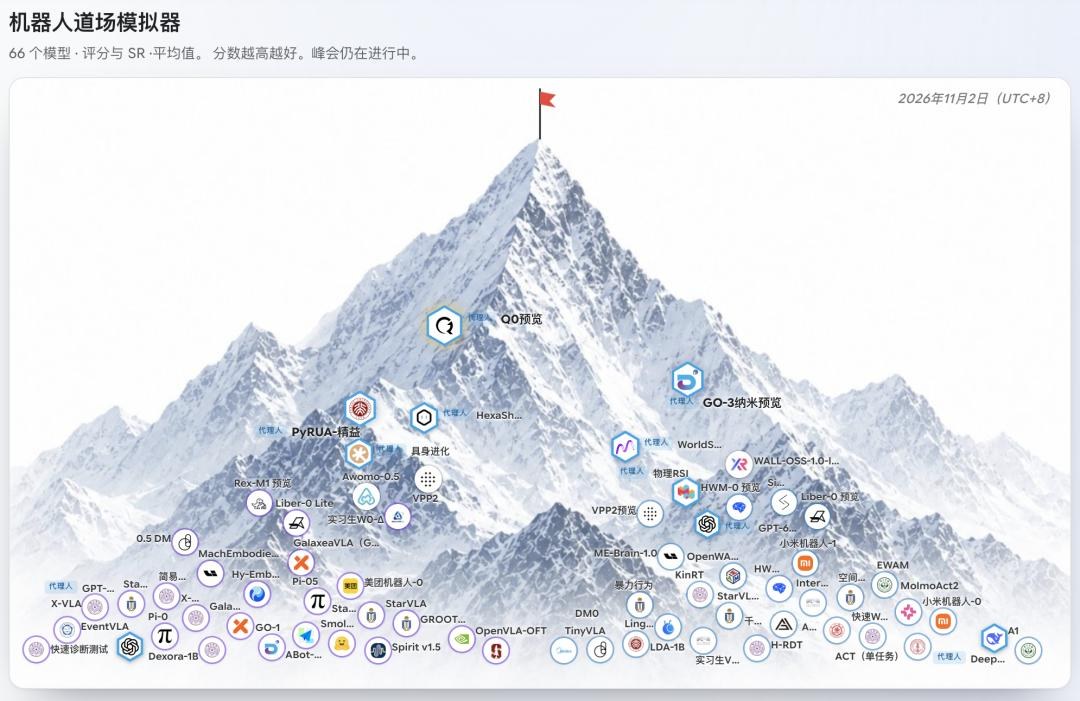
GPT-6 Astra 发布约两个月、GPT-6.2 Astra 亦在传闻中,具身智能赛道正被「通用大模型 + 机器人调用」路线正面冲击。据量子位报道,部分团队已裁撤算法岗;在 RoboDojo 等评测中,接入 Astra / Robot-Use-Agent(RUA)后,原本约 20–30 分的方案可抬到 50–60 分,逼问一句:还要不要继续砸预算训原生具身大模型?
冲击从哪来?
从业者感受是:具身侧迟迟等不到新的范式级突破,而 Astra 一类通用模型正以 coding / agent 方式「垂直打击」机器人任务。冲击不全来自海外——国内具身团队对 Kimi、DeepSeek、智谱等本土大模型的下一步同样敏感。
RoboTwin / RoboDojo 评测基准第一作者、港大 MMLab 博士生陈天行透露:一些原本坚持训练原生具身基础模型的团队,也开始提交结合 RUA、借助通用大模型完成机器人任务的方案。分数上去了,研发路线却被迫重估。可对照本站对 GPT-6.2 Astra 传闻 的跟踪。
Astra 一次打穿三项旧命题
陈天行用比喻形容差距:具身自研还在 80 分上加 0.1,Astra 可能一次性从 80 跳到 90。更扎心的是,部分测试中 Astra 未做任务专用后训练、未给示范,仅凭语言指令就能完成不少操作。
报告侧重点出三项过去可单独讲「创业故事」的能力,如今被通用模型一并逼近:
1. ICL(上下文学习):给图像/文字示范后成功率更高;改变摄像头与动作坐标系后,仍能在几轮尝试中在线修正。 2. OOD 与纠错:物体被挪动等分布外变化时,能据新视觉重规划,而不是死磕原轨迹。 3. 开放词汇操作:换说法提需求仍可执行,弱化「语言—动作」对齐上的专用后训练依赖。
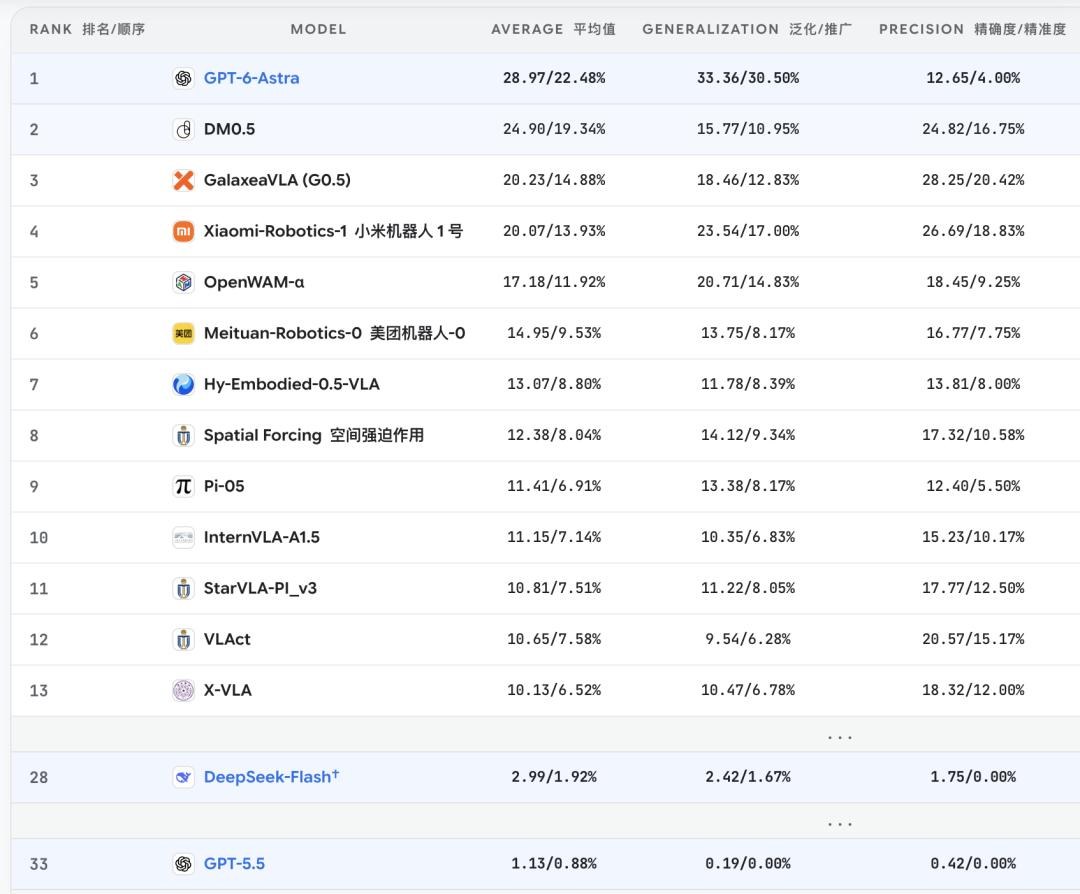
RoboDojo 团队同时提示:Astra 真机测试曾因安全问题中止;仿真高分不等于真实世界稳定生产力。但已足够让公司重审多年预训练投入——通用模型带着语言、视觉、推理与 coding 先验「空降」机器人,具身团队则常从有限操作数据里逐项磨能力,起跑线本就不对称。
自研还要不要?看物理接触与经济账
破壳机器人许华哲将能力拆为语义、空间、物理泛化:Astra 在前两项突出,复杂接触、受力、形变与高精度操作仍难。评测也显示几何对齐与语言理解是其强项,连续接触与多步骤物理操作上现有 VLA 仍有机会。自变量王潜强调:机器人数据、真机评测、硬件、仿真与部署等基础设施,不会因更强语言模型而自动消失。
延迟方面,Astra 云端 API 偏慢,对实时闭环是阻碍;但端侧量化、蒸馏与推理引擎可优化,且「模型推理频率」≠「底层控制频率」——流水线等可预规划场景,高层规划慢、底层控制快未必致命。
陈天行的判断是:机会不在「谁的模型更聪明」,而在「谁创造更好经济效益」。标准化产线更在意成功率、节拍与成本,专用小模型或规则策略可能比次次调用 Astra 更划算;家庭等开放任务则更吃通用理解与规划。他用「场景需求 × 模型能力」两轴说明:开放任务借通用模型,稳定任务用规则/轻量策略,中间留给场景优化模型——与本站讨论的 具身场景与物理 Agent 方向一致。
结论不是「自研无用」,而是自研优先级要重排:语言理解与任务规划可更多借用通用模型;物理交互、本体控制、真机适配与部署效率仍需专项研发。是否继续从头训更大具身基模,要看能否提供足够持久、可核算的优势。行业情绪上,「投资人更挑具身」的声音在放大,Demo 烧钱阶段正在进入淘汰赛——更多动态见 AI资讯。
常见问题
Q:Astra 是否已经替代具身专用模型? A:仿真与部分指令任务上冲击很大,但真机曾因安全中止测试;复杂物理接触与高精度操作上,专用 VLA / 场景模型仍有空间。
Q:为什么分数跳涨会冲击自研预算? A:接入通用模型 + RUA 后评测可从约 20–30 分升到 50–60 分,投资与管理层会追问「是否还要同等规模地预训练原生具身大模型」。
Q:产线该用大模型还是小模型? A:高度重复、成本敏感的任务更适合规则或轻量专用模型;任务多变、开放环境更吃通用模型的理解与规划,最终要算成功率、节拍、失败人工与长期部署成本。
相关文章