

Claude Code 桌面版负责人 Felix Rieseberg 把「用 AI 要更大胆」拆成可执行的方法:不要把「10 秒加载压到 5 秒」当目标,直接要求 0.2 秒,并告诉模型这完全合理;同时把任务从名词改成动词,用外部结果而不是模型自评来验收。他说这些做法不绑定某一家模型,前提是模型能操作电脑、装软件并读到原始数据。
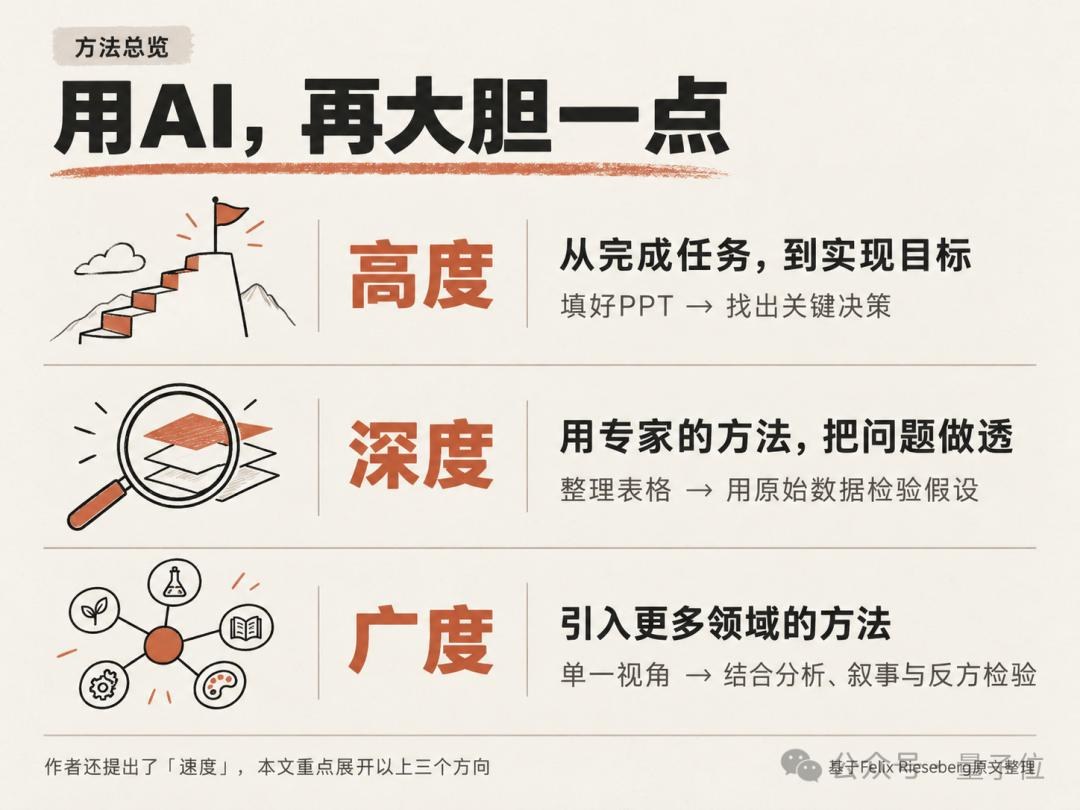
高度:先问结果,再问任务
他用自己的例子:从「修一个崩溃」升级成「应用保持不崩溃」。后者要求先把崩溃报告、版本对应的 Git 提交,以及 Windows、macOS、Linux 环境交给模型,它才能自己复现并验证修复。
季度复盘也可以按三层加码。先让模型基于尽量完整的数据回答「变了什么、为什么、下一步」;再让它列出最迫切的三项决策及正反理由;最后让它设计比季度 PPT 更早发现问题的机制,并用本公司历史数据证明,再与旧方法并行一个季度。判断标准是:这件事后面还要开会,就值得把目标再抬一层。他同时承认,2026 年对多数公司说一句「去赚钱」仍不会自动运转。
深度:用专家的工具,并禁止自评
「像专家一样想」往往只换措辞。他要求改用该领域顶尖人士的工具:数据问题用数据库和统计模型,而不是 Markdown 表格。再叠加四步:把目标定到模型会说「做不到」的程度并坚持可解;用原始数据复现你已有的结论(例如「流失是新手引导的问题」);在数据里找尚未知道的早期信号,并用模型没见过的数据验证;验收交给可自动运行的外部结果,而不是让模型给自己打分。截至他写作时的 2026 年 10 月,他仍强调外部验证。
可先让模型改写提示词:顶尖从业者还会做什么、从哪些原始材料入手、用什么方法和工具、除了对话双方谁能证明结果正确。编程场景上,本站此前写过 Claude 接管真实环境,可对照「给工具和权限,而不是只给一句指令」。
广度:借别的领域,但别玩角色扮演
把「做一份 PPT」改成「30 分钟内让忙碌的人接受一套因果解释,并在不确定时做决定」(他引用 Kelley 与 Littman《创新的艺术》里「名词换动词」)。再问:若这件事必须做成,人类会召集哪些职能——分析、编辑、动效、挑错——然后让模型使用这些领域的方法,而不是扮演这些人。他提到同事用 Blender 做室内渲染后,自己才用 Claude 给主页做 3D 环境。前提仍是一台能装软件、能通过 MCP 或其他方式读到数据的电脑。
为什么他把这说成自我效能
后半段他把问题从提示词转到人:Locke 与 Latham 对 35 年目标研究的结论是,清晰且有难度的目标优于「尽力而为」。他用 Dantzig 把未解统计题当成作业、Bannister 1954 年 5 月打破四分钟一英里后 46 天即有人跟上,以及原文所称今年 4 月伦敦马拉松 Sabastian Sawe 跑进两小时、亚军同样破 2,说明「看见别人做到」会改写可能边界。Anthropic 这边的产品与治理背景,可见 Jack Clark 从记者到联合创始人。
常见问题
Q:Felix 说的「不合理目标」具体指什么? A:以性能为例,想从 10 秒做到 5 秒时,直接要求 0.2 秒,并在模型拒绝后继续声明问题可解、要求再试。目的是抬高搜索上限,不是假装 0.2 秒一定能达到。
Q:怎样避免模型只换一套专业口吻? A:指定原始数据和专家工具(数据库、统计模型、可运行的检验),并禁止模型自评;代码要跑,预测要用没见过的数据验证。
Q:这些方法是否只适用于 Claude? A:他写明不针对单一模型,但需要模型能操作电脑、安装软件,并通过 MCP 或其他接口访问相关数据。
相关文章