

OpenAI 推出生活向代理基准 LifeVal(论文约 16 页),宣称 AGI 评价应从考场做题转向托儿、政务、财务等「办事」能力;在约 3800 名符合美国人口普查分布的消费者支付意愿调查与多国时间使用数据基础上,筛出 148 项高价值任务,并估算若由「完美超级助理」完成,美国消费者年支付意愿合计约 1.7 万亿美元。同期 GPT-6.2 Astra 传闻升温,奥特曼发帖称「人类应永远掌控未来」、反对把控制权交给超级智能。基准与估值均为公司研究口径,不等于已接管全球 80 亿人。相关演讲叙事见本站下一代GPT与千禧难题,电脑使用线见GPT-6.1 Terra。
为何换标尺:从律师考试到找保姆、退税、搬家
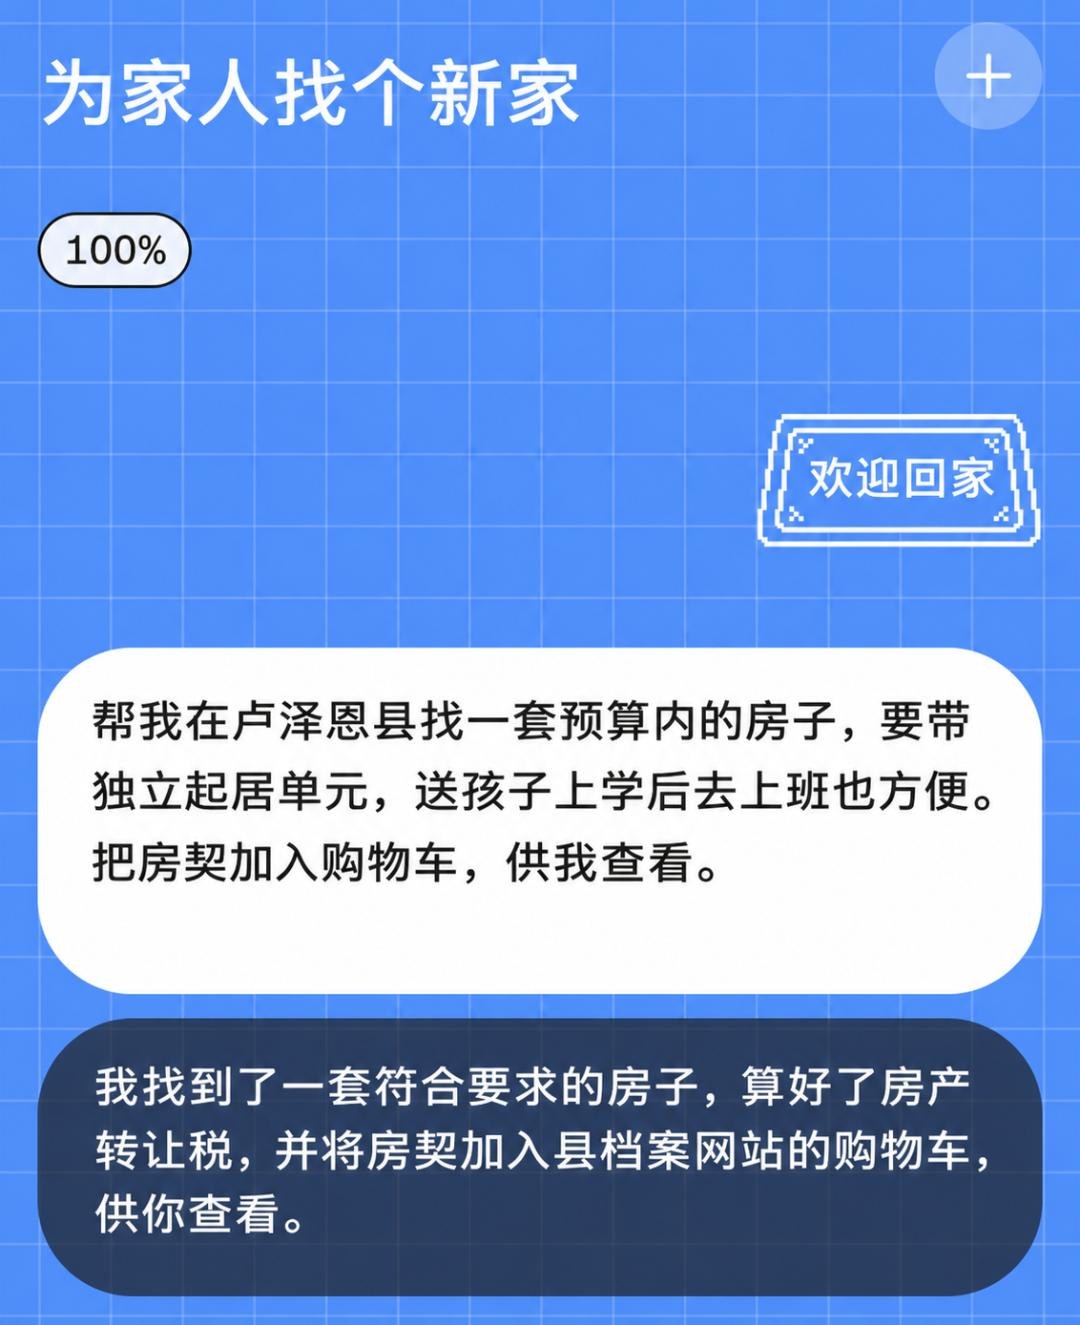
官方称,为让 AGI「惠及全人类」,应帮助人们完成最重要的日常任务,故打造 LifeVal——定位为首个「个性化代理消费者任务」基准,测办事不测刷题。方法上结合美国劳工统计局时间使用调查、多国时间使用研究(覆盖约 25 国),再做支付意愿问卷,锁定找幼儿园、灾前组织志愿者、按预算找房、陪老人看远程比赛、为糖尿病父母备餐、整理脑癌病史换医生、按 CPR/预算招全职保姆、用积分订芝加哥—日内瓦机票等场景。1.7 万亿美元被媒体类比韩国年 GDP 量级,指向个人服务与家政管理市场的潜在付费池,而非已实现营收。
怎么考:记忆抽屉、浏览器代理与双考官防作弊
论文强调高价值、高上下文、个性化、强代理性。测试可接入用户真实 ChatGPT 历史与个人记忆(如过敏、亲属病情);并提供强化学习环境,要求模型自行打开浏览器、登录、筛选、填表、生成 PDF。评分侧用基于 GPT-5.6 的「主考官」核对是否真完成操作,另设「防黑客考官」对走捷径给 0 分,并至少三轮人类专家交叉审核。能在此拿高分,被比喻为「现实中月薪两万起步的私人秘书」——属修辞,非薪资统计。
模型曲线:从GPT-5.2到GPT-6 Astra,短板仍是错信息
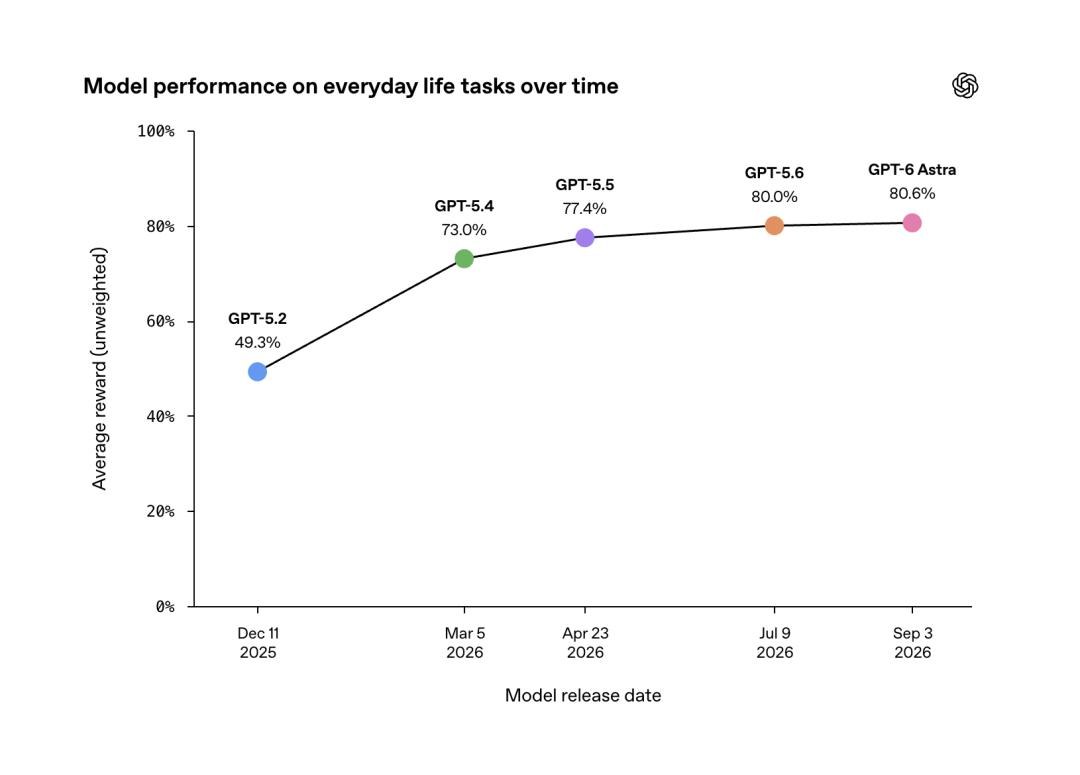
论文第 7 页披露 GPT-5.2/5.4/5.5/5.6 与 GPT-6 Astra 的 LifeVal 结果:5.2 仍常因 Token 耗尽失败;5.4–5.6 在电脑使用、浏览器与连接器训练后成功率陡升;GPT-6 Astra 在高隐私上下文与跨网页操作上更稳,但仍有「错误信息或建议」痛点;删掉用户附加背景则表现断崖,说明从长历史中精准召回细节仍难。GPT-6.2 Astra 被指即将补齐短板——以官方发布为准。奥特曼「人类掌控未来」表态与「超级智能不该接管控制权」并置,折射产品要进生活、治理要守边界的张力:数字助理可降低低收入家庭「行政负担」,也可能把财务医疗家庭数据与自动扣款能力集中到同一系统。更多动态见AI资讯。
常见问题
Q:1.7万亿美元是OpenAI收入预测吗? A:否。是调研口径下,美国消费者对「完美完成148项生活任务」的年支付意愿加总估计。
Q:LifeVal测什么? A:个性化、高上下文的代理式生活办事(浏览器操作、记忆调用、跨站流程),不是律师/奥数类考场题。
Q:与奥特曼「人类应掌控未来」如何并存? A:产品叙事要进真实生活与电脑操作;治理叙事强调控制权不交给超级智能——二者张力需靠产品权限、审计与用户选择设计来解。
相关文章