

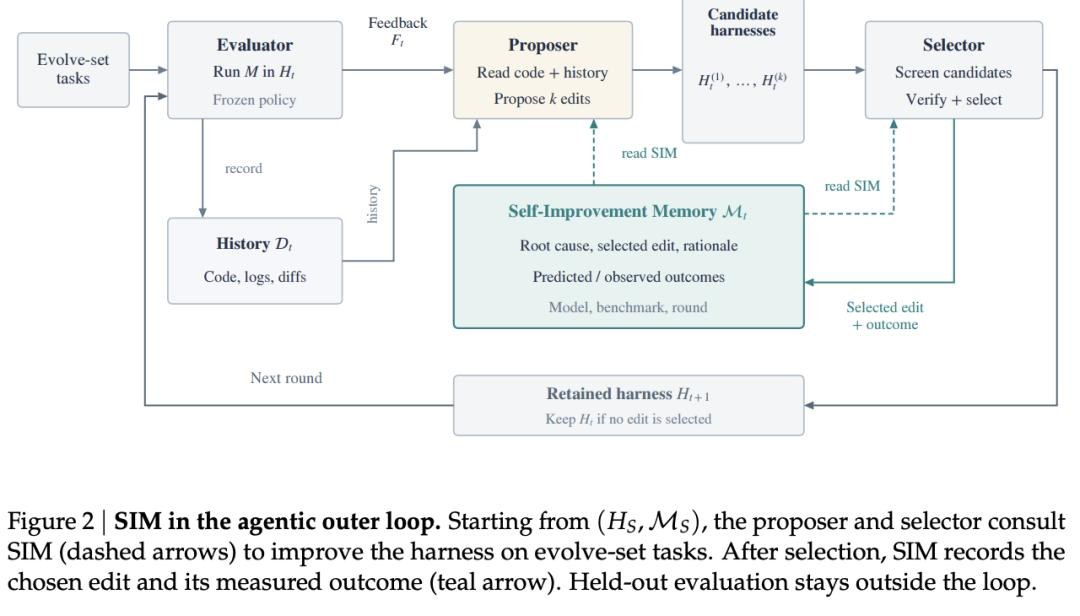
11 月 13 日,谷歌云、Google DeepMind 与宾夕法尼亚州立大学的研究者在 arXiv 发布论文《Self-Improvement Memory Enables Continual Recursive Self-Improvement》(2611.18856)。论文研究的是套在模型外面的 Harness,也就是提示词、工具和拦截规则,不是去改模型权重。Self-Improvement Memory(SIM)记的是优化器每次改了什么、为什么改、预期和实际结果,以及当时用的模型和数据集。策略模型的权重在实验里保持冻结。
换模型时,只交出代码往往更差
论文把设定叫做 CRSI:已有的 Harness 优化,换到兼容的基准或策略模型之后还能接着做。对照有四种。Cold Start 从种子 Harness 从头开始。Harness Transfer 只继承上一个模型改好的代码。Problem-Only Memory 只告诉新优化器过去遇到什么问题。Full SIM 同时交出 Harness 和完整日志。
跨模型实验里,源阶段用 Claude Opus 5.5 做 RSI,再交给 Gemini 3.8 Flash 在同一基准上继续。Workspace 上,Opus 进化出的 Harness 接到 Gemini 时起点是 68.41,低于种子 Harness 的 73.89。两边都从 68.41 继续优化后,只传代码到 73.42,Full SIM 到 84.75,相差 11.33 分。四个领域里,Full SIM 都高于只传代码,高出 3.60 到 11.33 分,也都高于只传根因的对照。只传代码的结果在其中三个领域仍低于冷启动。
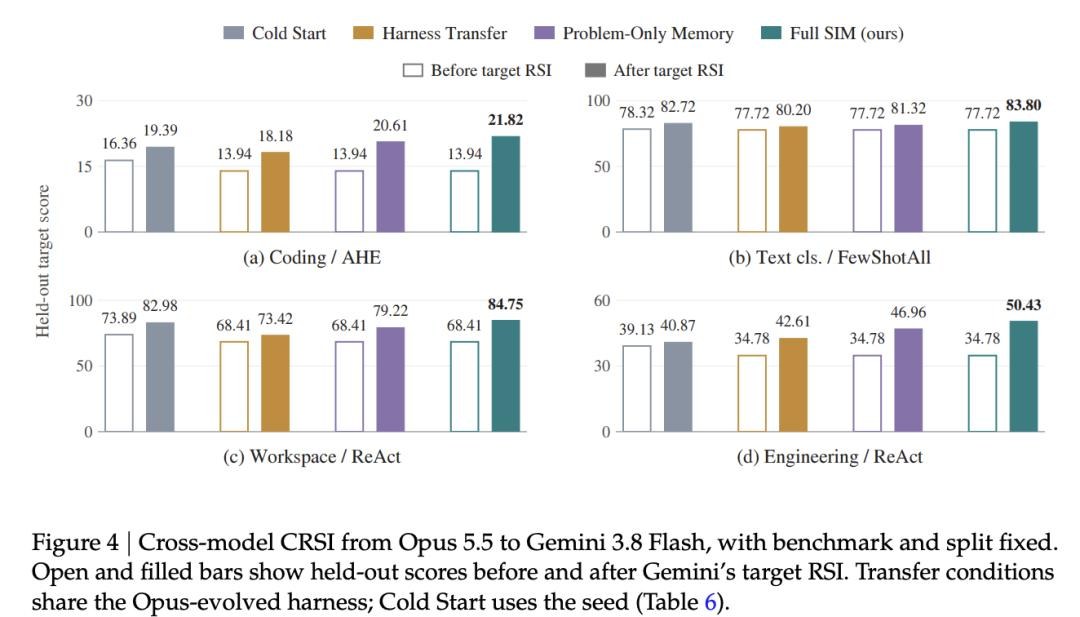
编码任务上,十次独立的源运行做成配对续写。带 SIM 的九次高于只传代码,平均高 2.36 分,p=0.003。文本分类里也有同样的起点落差:源阶段进化出的 FewShotAll Harness 在目标数据集上是 72.92,低于种子的 75.72。跨数据集实验两端都用 Gemini 3.8 Flash。论文写,在所给预算下,六个跨数据集设定和四个 Opus 到 Gemini 的设定里,Full SIM 高于只传代码和只传根因。
附录里的一个案例是完工门槛。没有 SIM 时,同一次运行把这个门槛改了四次,其中两次是在修自己造成的完工死锁,并把继承来的门槛误记成自己第一轮加上的。论文举例说,一个只检查命令有没有跑通的门槛,换了任务之后可能还要检查可行解是不是最优。这是 Harness 规则的延续,不是模型权重记住了上一个模型。
不是每一格都高于从头优化
论文另有一张表,比较同一套 Gemini 模型在 held-out TB2.1 上的成功率:未进化的种子、从头做的 RSI,以及带 SIM 的 CRSI。Gemini 2.5 Flash 是 17.8、21.4、22.4。3.5 Flash 是 70.2、73.3、76.8。3.8 Flash 是 87.2、88.9、90.5。Gemini 4 Argon 是 89.7、95.6、94.8。最后一行里,从头优化的 95.6 高于带 SIM 续写的 94.8。所以这篇论文没有给出「每一代都更高」的结果。
同一时期对外发布的 Gemini 4 Neon 是产品模型,见Gemini 4 Neon 与 Genie 4。这篇论文没有写 Neon 的发布是由 SIM 造成的。第一作者 Xin Yu 的脚注写明,工作完成于他在谷歌实习期间,单位同时列了宾夕法尼亚州立大学。
常见问题
Q:SIM 是模型自己的记忆吗? A:不是。论文写明它配给 Harness 优化器,策略模型权重冻结。日志按反复出现的问题分组,记下修改理由、预期结果、实际结果和评估时的模型与数据集。
Q:Opus 上进化好的 Harness 能直接套到 Gemini 吗? A:Workspace 实验里,套过去的起点是 68.41,低于 Gemini 种子 Harness 的 73.89。带完整 SIM 后续到 84.75,只传代码到 73.42。
Q:带 SIM 是否每次都更好? A:相对只传代码和只传根因,论文报告的跨数据集和跨模型比较里 Full SIM 更高。相对从头优化,Gemini 4 Argon 在 held-out TB2.1 上是 94.8 对 95.6,带 SIM 的那一格更低。
相关文章