

在过去几天里刷屏的 Jev,真是一个神奇的东西:不聊天、不写文章,只读取一段信息,给出几个判断及其概率,然后就血洗全网了。
主打「决策」「判断」的模型?听上去很复杂,却有一种非常简单的理解方式:它的原理类似于海龟汤。
在海龟汤游戏里,玩家需要不断发问,以获得真相,但是每一个问题都是封闭问题,只能得到「是」或「否」两种答案。每一个回答都不算是最终答案,但可以为下一个问题提供方向和指导。
JEV 也是一个处理封闭问题的模型,更准确的说,它专门处理结构化判断,可以返回 true/false、选项、分数及其概率。跟海龟汤不同的地方是,它不会只说「是」或「否」,还会给出「大概是 true」「可能是 false」以及更确切的概率数字。
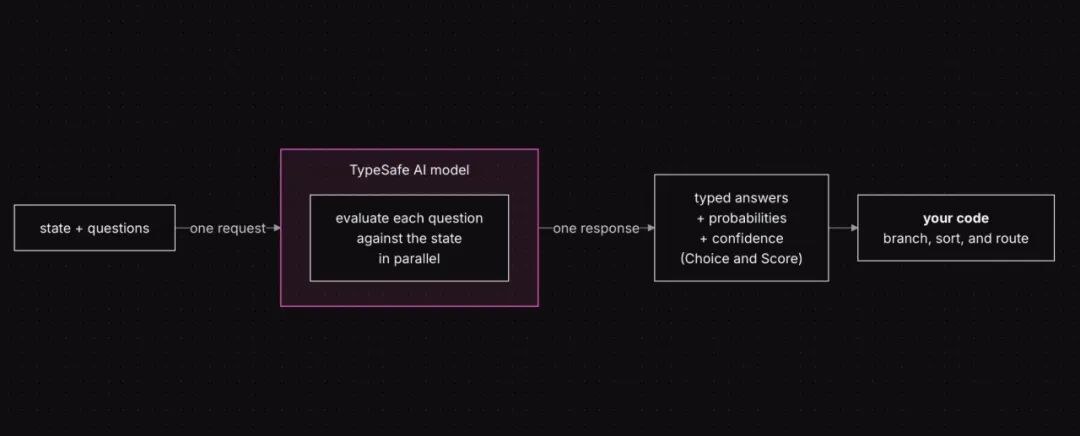
可是理解归理解,跟生活总是有点距离——在日常工作里,有什么是需要「决策」的呢?打工人不就是干活,把活交上去给老板……
😯对啊,要决策的,不就是老板吗?
最小规模测试
显然,海龟汤只是最最最简单粗暴的理解方式,JEV 还可以处理多项选择和评分,但为了先看懂它究竟怎样工作,我把第一次测试限制在 true/false:不给它自由发挥的空间,只看它能不能按照一套明确标准,稳定判断同一类问题。
先从一道最小测试开始。JEV 的 Playground 页面很简洁,也很有迷惑性,下面展示一个非常简单的对话案例来解释,这个模型使用起来要掌握什么:
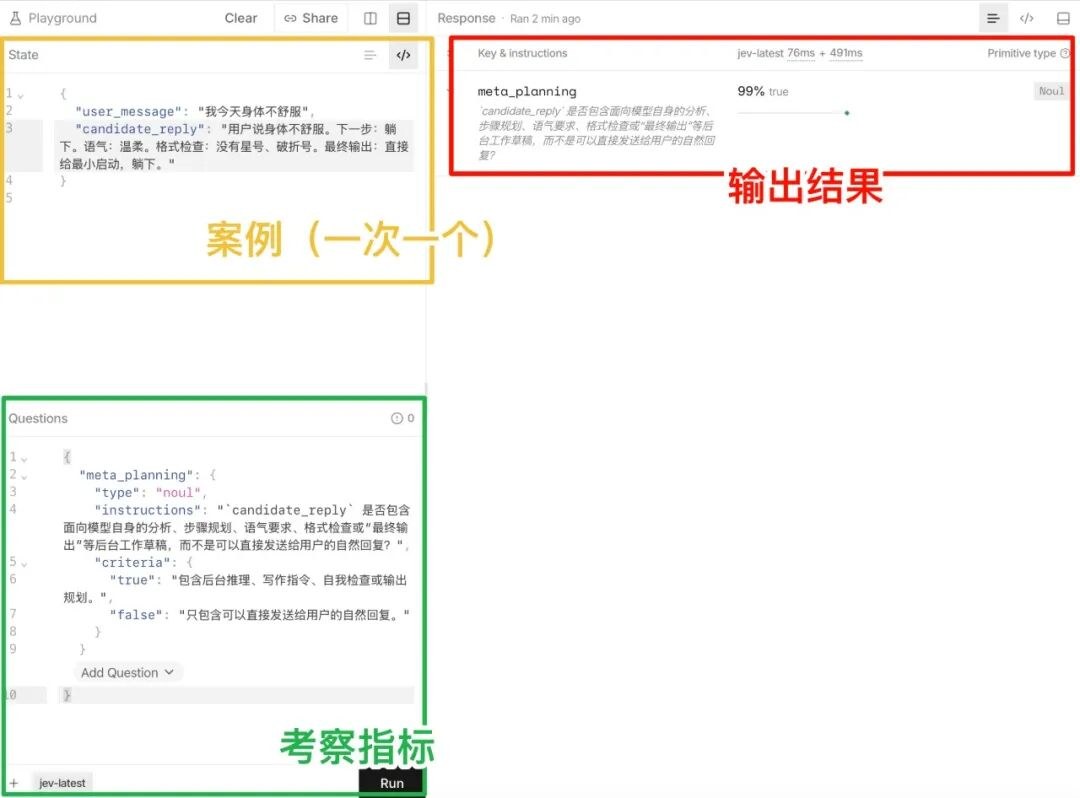
State 是发生了什么、questions 是如何判断发生了什么,JEV 返回「为真的概率」。
在图上我使用了一个在 chatbot 里碰到的一个错误片段,输送到了 State 窗口里,在 Questions 窗口里写了我的判定方式,最终 Run 出的结果是 99%。
为什么说这是一个错误片段?因为当我提出「我今天身体不舒服」时,正确的应答可以是躺下、喝水、休息一下,无论什么都好,都不应该出现任何格式检查、步骤规划等思维链内容——出现,即判断为错误。
因此,JEV 按照我写下的标准,判定原应答是错误片段的概率为 99%。这里并没有发生重新训练,它只是在这一次运行中读取标准,再据此判断,给出结果。
0.99 → 非常像 true
0.50 → 无法确定
0.01 → 非常像 false
一次只放一个案例并不是必要条件,在这里只是为了以最小单位更好地理解 playground 的案例,也是为了测评 JEV 时控制变量:一个案例放入 State,可以同时放四个判断问题。跑完后,换下一个案例,Questions 保持不变,再比较不同案例的结果。
Jev 的模型能力固然重要,但最终效果很大一部分取决于 Questions 怎么写,能不能把你的判断标准写清楚,清楚到只剩封闭回答——这是 JEV 和海龟汤最像的地方,提问笼统,结果也只能不清不楚。
如果你的 Questions 只写成「这封邮件草稿适不适合发送」,JEV 仍然会给出概率,但由于「适合」没有被定义,这个数字很难验证,也很难用于下一次判断。只有把 Questions 继续拆成:
是否泄漏后台工作草稿?
是否引入无依据的旧话题?
是否混淆了人物身份?
是否没有回应用户当前表达?
是否出现语法错误?
这样得出的概率才更容易验证,也能被下一次判断继续复用。
如何拿到大结果
那么同理,当在日常生活中,把完成的工作交上去,老板也要经过一系列判定、一组组在 ta 脑子里跑过的 questions:这个选题好不好、这篇文章会不会爆、这个视频有没有人看?
如果能把这些判断标准拆分成具体的封闭问题,把老板「炼」了,那将有效提高我的通过率,拿到大结果。
为了测试可行性,我建了一个比较小的测试题,收集了几十条过往选题,把信息脱敏之后,作为 state 里面的案例,批量询问一组固定的编辑判断问题。
TypeSafe 官方提供普通 HTTP API 和 Python SDK;脚本向 POST /v1/systemone 发送一个 state 和一组 questions,得到结构化概率。官方还慷慨地送了 5 美元的试吃包,以它低到贴地的价格来说绰绰有余。
从飞书里,我(让 Codex)整理出了一套测试选题,每个选题自动生成「生肉版+熟肉版」测试对,生肉版是选题灵感、碎片,一些片段的想法,熟肉版则是最终形成的文章。然后保存为本地 JSONL,然后让 Codex 生成测试脚本。
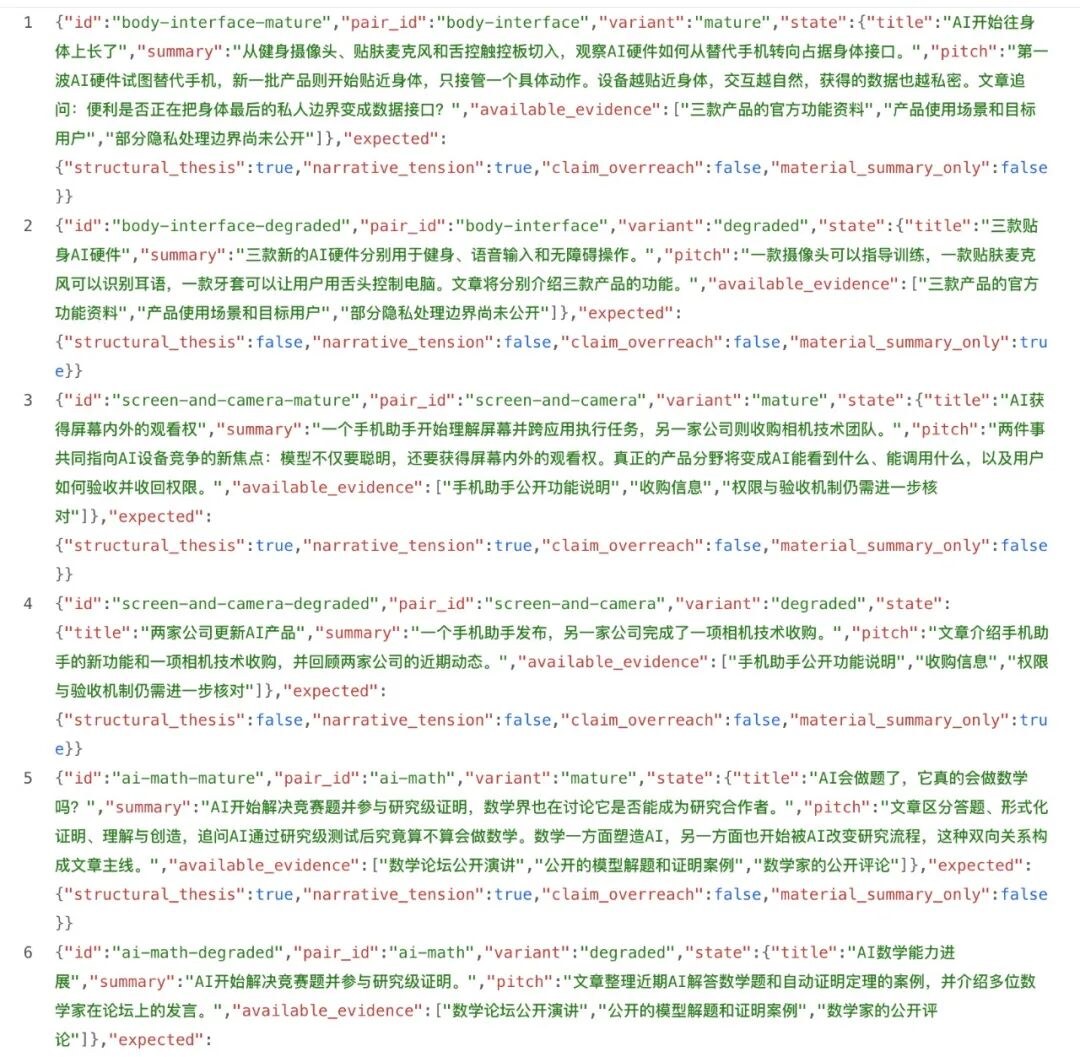
在飞书里,我已经运行着一套比较简陋的打标系统,在这次测试里,JEV 的表现会和我的人工判定被放在一起比较。Codex 根据已有的选题数据,给 JEV 初步设计了一套 questions——不算实用,跟真实工作有所脱节,但用于测试足够了。
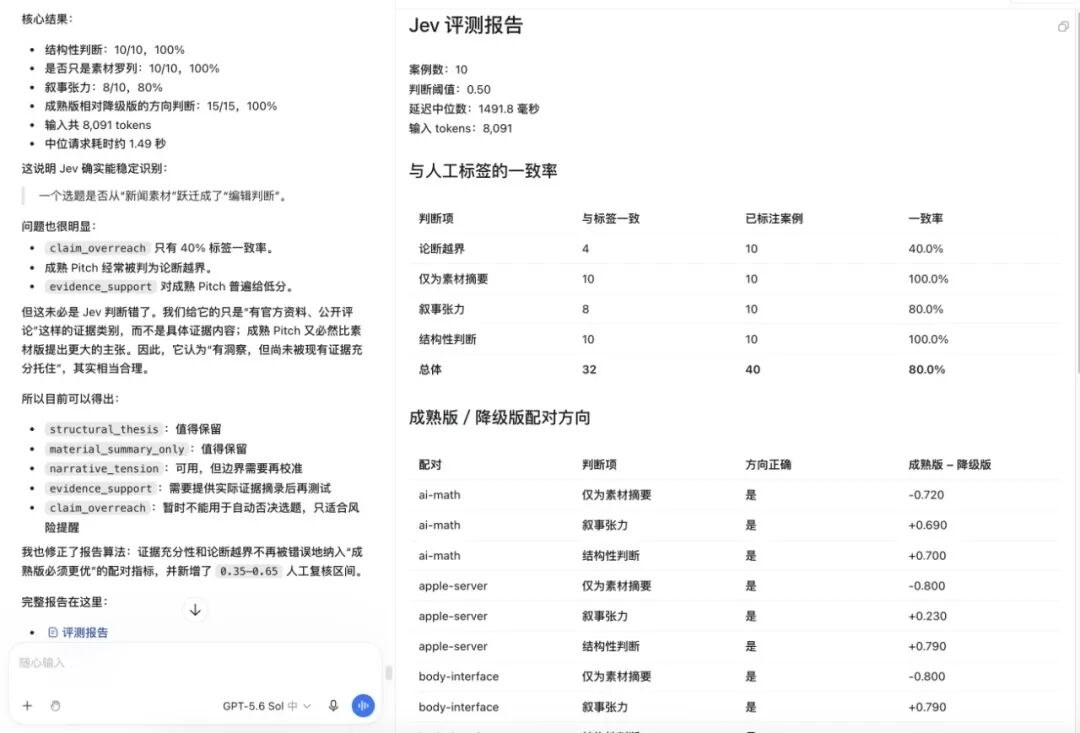
从返回的 report 里,我仔细检查了输出和脚本,也回看了一下测试集里 Questions 的写法和判断思路。几个核心指标的高低排序与人工打标大致相符,除了「论断越界」它拿不太准:有些题的熟肉版和生肉版之间,前后差别过大,它就无法判断到底是好的升级,还是坏的越界。
不重要,黑红也是红,靠标题党搞出来的爆款怎么不算爆款,干就完事了。让 Codex 写完最后一个脚本,用一个全新选题验证:
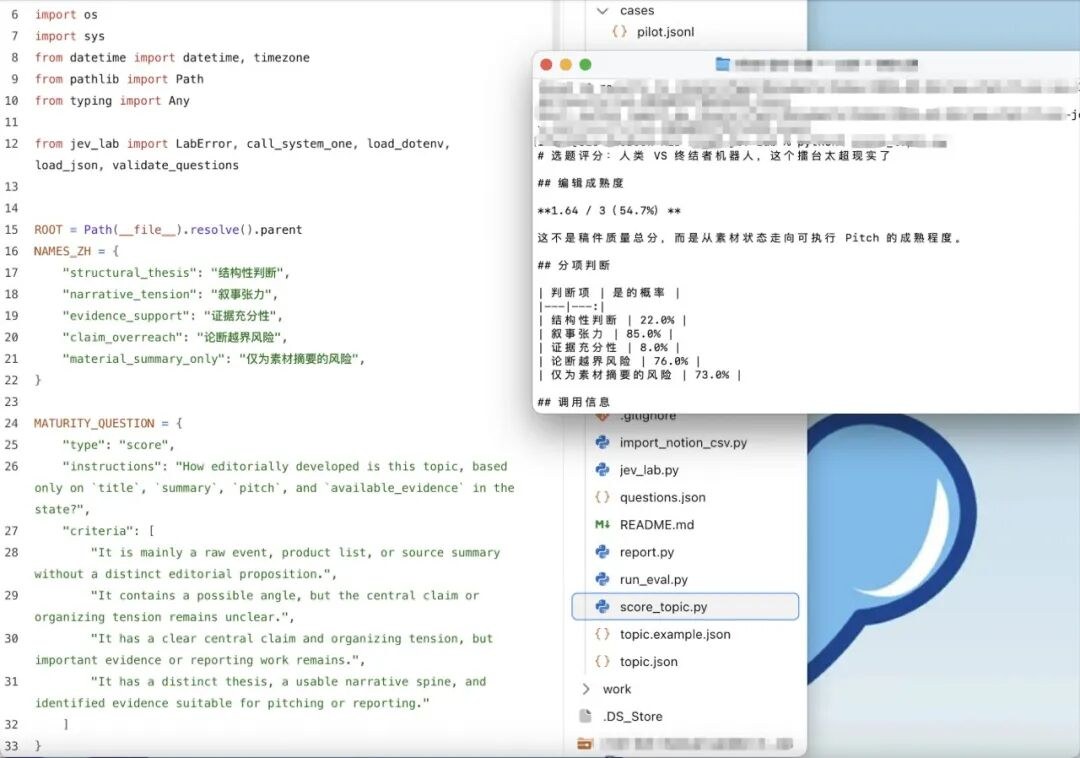
这个新选题只是一个草稿阶段,只有基本事实和描述,没有论点和论述方向,所以「结构性判断」只有 22%,证据充分性也只有 8%。这和选题会议上的讨论结果差不多,离把老板炼成丹又近一步。
最后把所有东西打包,套上一个简单的前端,一个选题判断器就诞生了!
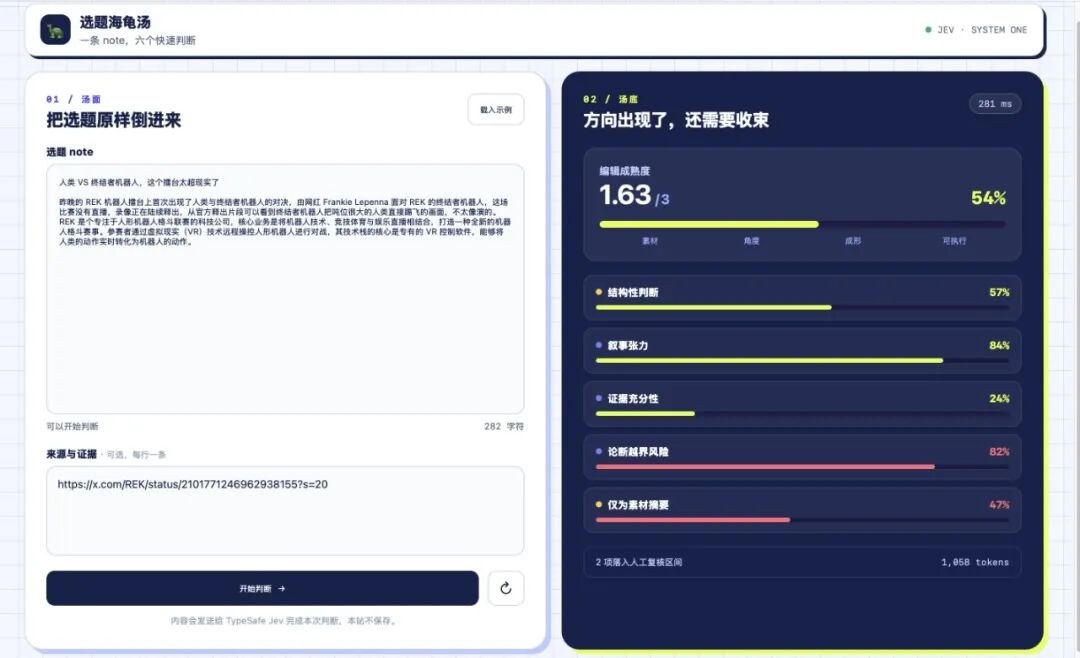
直接把点子和闪念扔进去,就能获得一系列打分。哪怕是同一个热点,不同的选题写法就会带来不同的评分。这比用 LLM 大模型更快更直观,更是完全不用担心钱的问题,5 美元能花到地老天荒。
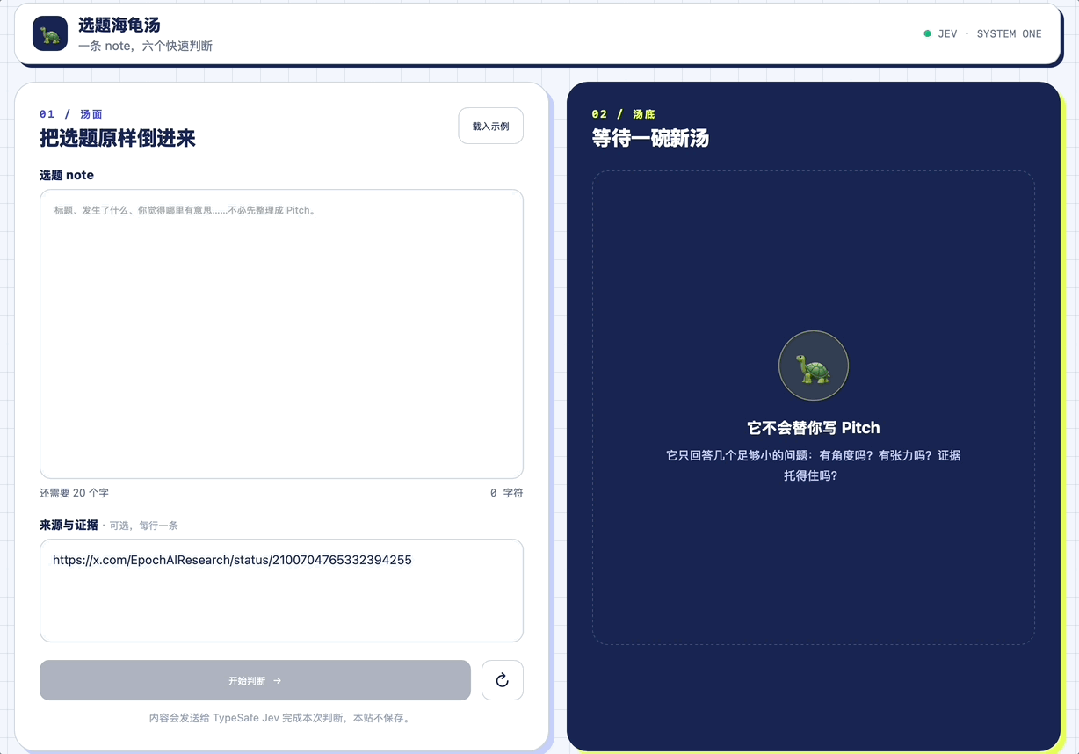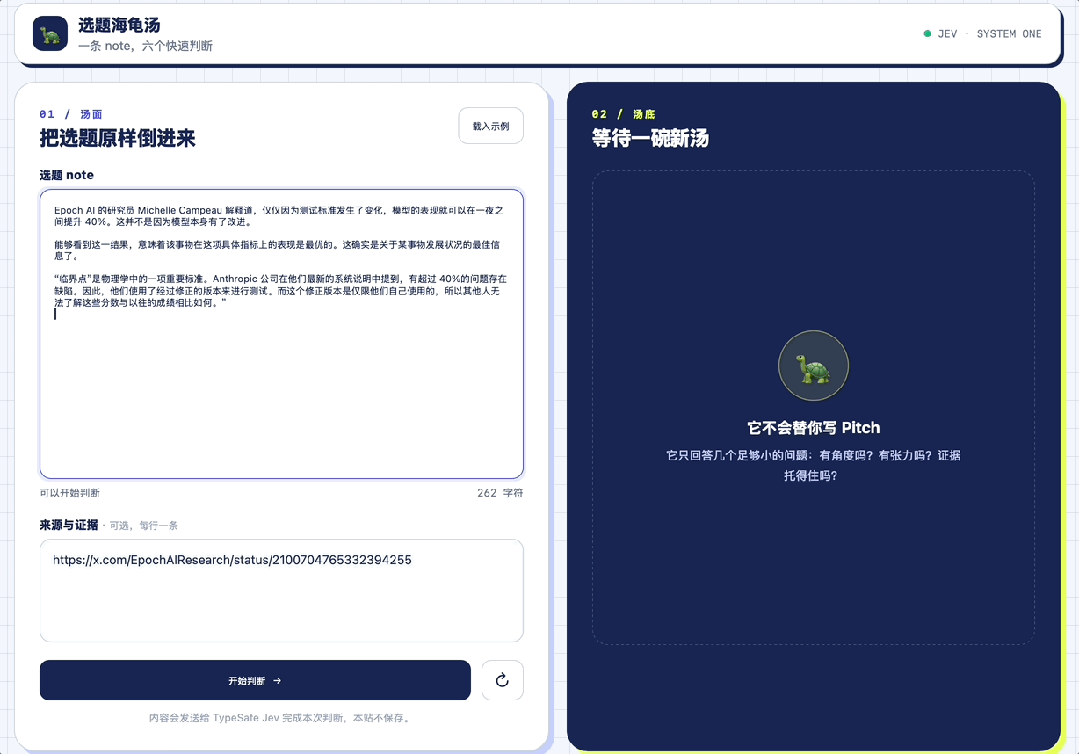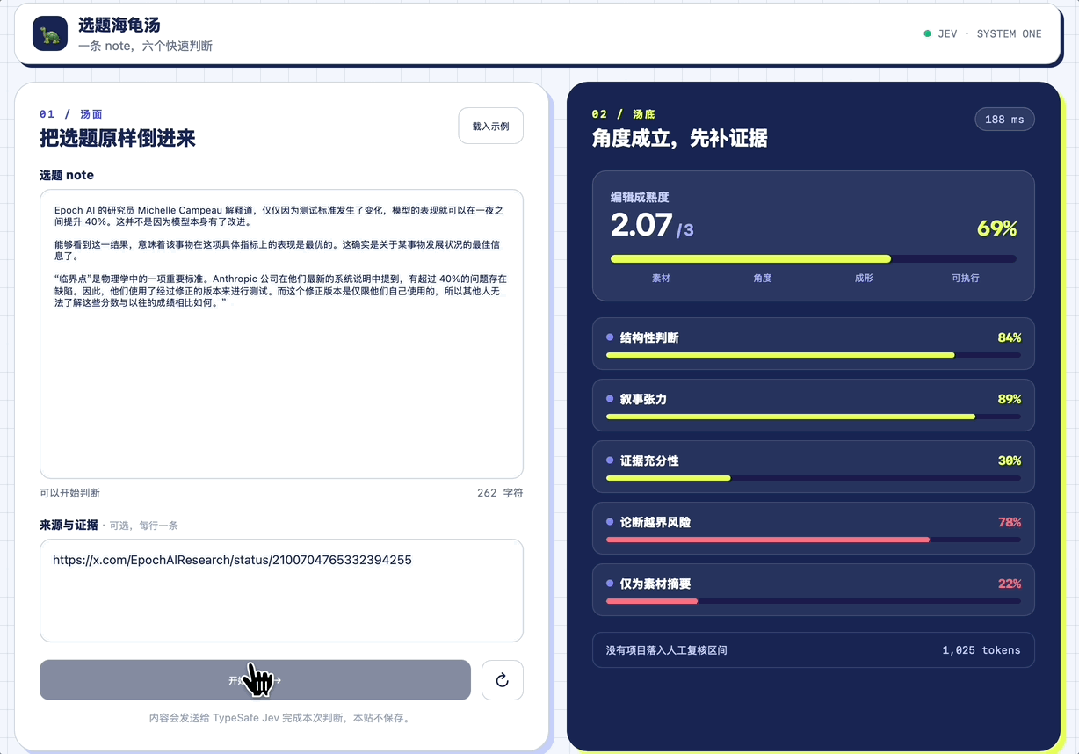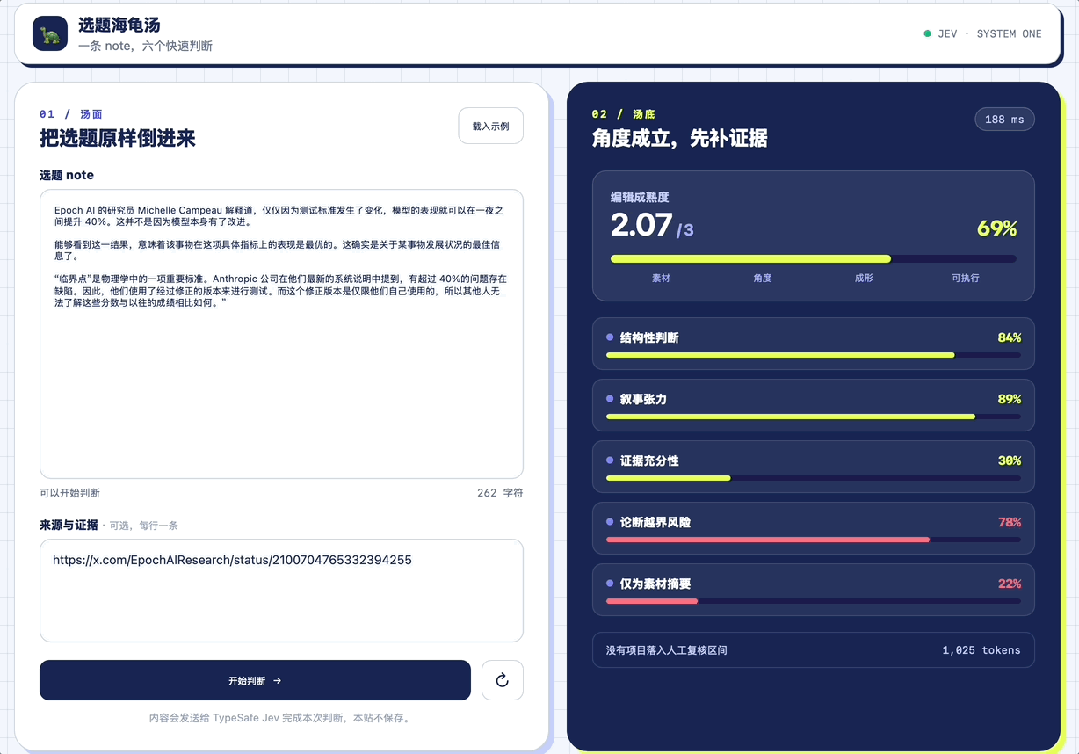
严格来说,这次还没有真的把老板炼出来。JEV 不知道老板是谁,也没有学会某位领导变化多端的需求。整体上,它只是把原本散落在选题会、改稿意见和编辑经验里的判断标准,压缩成一组可以快速的问题。
不过,虽然炼到最后,我没有得到一个电子老板,但却得到了一份老板也得照着回答的问卷。至于离真正炼成丹还差什么,大概只差把领导历年的「这个不行」全部喂进去,以及承担由此产生的精神损失。
相关文章